AWS gibt eine ganze Region auf – wer kein eigenes Backup hat, hat ein Problem
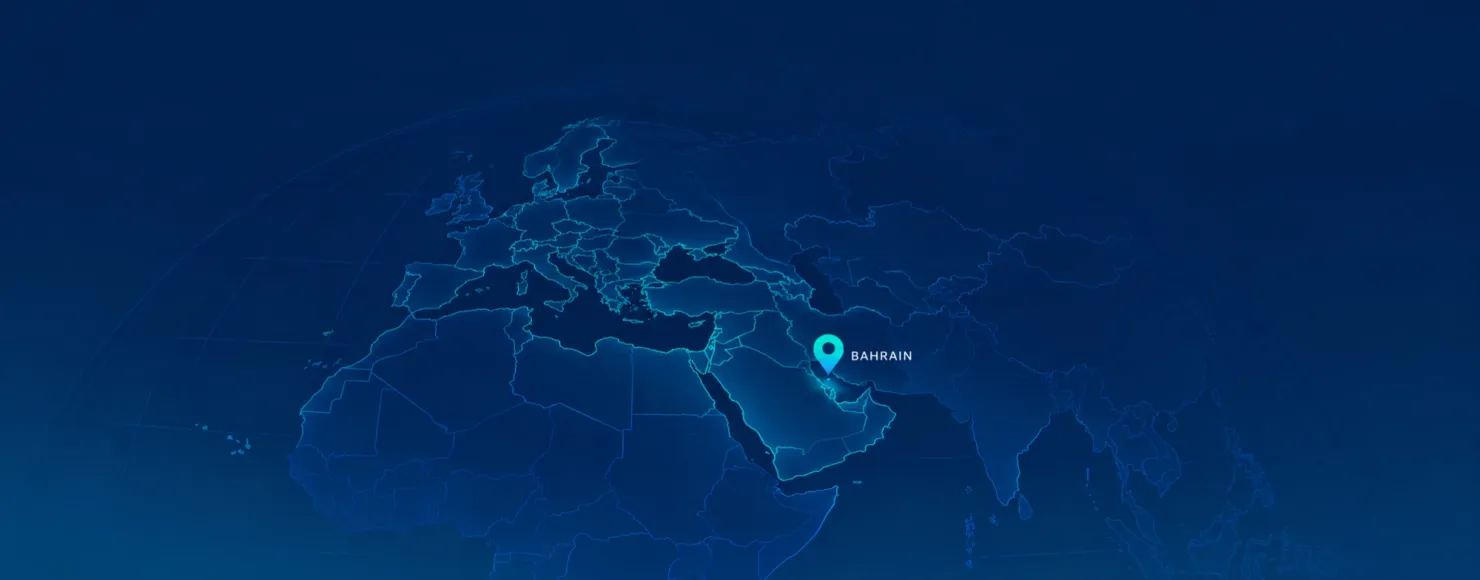
Am 15. September hat AWS mitgeteilt, dass sich eine der drei Availability Zones in den Vereinigten Arabischen Emiraten und das gesamte Netz in Bahrain nicht wiederherstellen lassen. Daten, die ausschließlich dort lagen, sind nicht mehr zugänglich. Ein Update zur Lage in Bahrain hat AWS für Anfang 2027 angekündigt; für die VAE nannte das Unternehmen keinen Zeitrahmen.
Hinter diesem Vorgang steht ein Krieg mit Folgen, die weit über IT-Infrastruktur hinausgehen. Dieser Beitrag betrachtet bewusst nur die technische Seite, weil das der Teil ist, zu dem wir etwas beitragen können – nicht, weil er der wichtigste wäre.
Was passiert ist
Die Infrastruktur in Bahrain wurde im März zweimal und im April erneut beeinträchtigt. Nach Darstellung von AWS erstreckte sich der Schaden über mehrere Zonen und „überstieg das, wofür unsere regionalen und Multi-AZ-Dienste ausgelegt sind“. AWS hat nach eigenen Angaben alle Optionen zur Wiederherstellung geprüft und ausgeschöpft.
Der für uns aufschlussreichste Satz betrifft die Kunden in Bahrain: AWS habe sie beim Umzug in andere Regionen unterstützt – „mit Backups, wo vorhanden“, sonst mit Ersatzlösungen, um den Verlust der nicht mehr erreichbaren Daten abzufedern. Wer kein Backup hatte, bekam also Hilfe beim Neuanfang, aber seine Daten nicht zurück. Genau diese Einschränkung ist der Punkt.
Quellen: The National und heise online.
Das ist kein AWS-Versagen
Der naheliegende Reflex wäre, daraus einen Vorwurf an den Anbieter zu machen. Das wäre falsch und würde die Lehre verfehlen.
Availability Zones sind gegen Stromausfall, Brand, Hardwaredefekte und lokale Ausfälle ausgelegt. Sie sind nicht gegen die gleichzeitige physische Zerstörung mehrerer Standorte ausgelegt, und kein Anbieter behauptet das. Jeder Hyperscaler, jeder europäische Provider und jedes eigene Rechenzentrum hätte unter denselben Bedingungen kaum anders dagestanden.
Was der Vorgang zeigt, ist nicht die Schwäche eines Anbieters, sondern eine Annahme, die in vielen Architekturen steckt, ohne je ausgesprochen worden zu sein: dass die Region immer da sein wird.
Drei Verwechslungen
Redundanz ist kein Backup
Ein über drei Zonen repliziertes Volume ist hochverfügbar. Es ist kein Backup. Redundanz schützt vor dem Ausfall einer Komponente, nicht vor dem Verlust des Gesamtsystems – und auch nicht vor gelöschten Daten, fehlerhaften Deployments oder Ransomware, die sich brav in alle Repliken schreibt.
Multi-AZ ist keine Multi-Region
Drei Zonen liegen in derselben Region, nach Angaben von AWS höchstens rund 100 Kilometer voneinander entfernt. Gegen ein Ereignis, das die Region als Ganzes trifft, helfen sie nicht. Multi-AZ ist die Standardarchitektur, weil sie bequem und günstig ist; Multi-Region kostet Aufwand und wird deshalb regelmäßig auf später verschoben.
„Der Anbieter hat ein Backup“ heißt nicht, dass du eines hast
Die wenigsten Managed Services sichern deine Daten so, dass du sie unabhängig vom Anbieter zurückspielen könntest. Snapshots liegen standardmäßig im selben Konto, oft in derselben Region, und sind an die Plattform gebunden, die sie erzeugt hat. Ein Backup, das nur innerhalb des Systems existiert, das ausfallen kann, ist kein Backup.
Die Frage ist nicht, ob deine Daten gesichert sind. Sie lautet: Wer könnte sie zurückspielen, wenn der Anbieter morgen nicht mehr erreichbar wäre?
Wo die Verantwortung liegt
Im Shared-Responsibility-Modell ist die Aufteilung an dieser Stelle eindeutig, wird aber selten gelesen: Der Anbieter verantwortet die Verfügbarkeit der Infrastruktur. Die Sicherung der Kundendaten und deren Wiederherstellbarkeit verantwortet der Kunde.
Das ist keine juristische Spitzfindigkeit, sondern eine Arbeitsaufteilung, aus der eine konkrete Aufgabe folgt. Wenn niemand in deiner Organisation diese Aufgabe namentlich zugewiesen bekommen hat, ist sie nicht erledigt – unabhängig davon, wie viele Häkchen in der Konsole gesetzt sind.
Was praktisch daraus folgt
- Eine Kopie außerhalb des Anbieters. Die klassische 3-2-1-Regel ist alt und trotzdem unschlagbar: drei Kopien, zwei Medien oder Systeme, eine außerhalb. „Außerhalb“ heißt heute: bei einem anderen Anbieter oder im eigenen Rechenzentrum, nicht in einer anderen Region desselben Kontos.
- Offene Formate. Ein Datenbank-Dump lässt sich überall einspielen. Ein proprietärer Snapshot nur dort, wo er entstanden ist.
- Der Systemzustand als Code. Daten allein reichen nicht. Ohne Infrastructure as Code und GitOps hast du im Ernstfall deine Daten, aber keine Umgebung, in die sie passen.
- Ein Restore, der stattgefunden hat. Nicht geplant, nicht dokumentiert – durchgeführt, mit Zeitmessung und einem Protokoll, das festhält, was gefehlt hat.
- Eine benannte Person. Backup ist eine Rolle, kein Feature.
Der unbequeme Teil
Von diesen fünf Punkten ist der vierte der einzige, der wirklich weh tut, und deshalb der einzige, der regelmäßig ausgelassen wird. Ein Restore-Test bindet ein Team für einen Tag, produziert nichts Sichtbares und fördert Unangenehmes zutage: fehlende Zugangsdaten, undokumentierte Abhängigkeiten, Datenbestände, die niemand vermisst hatte.
Genau das ist sein Zweck. Ein Backup-Konzept, das nie zurückgespielt wurde, ist eine Absichtserklärung. Der Unterschied zwischen beidem zeigt sich zuverlässig zum ungünstigsten Zeitpunkt.
Fazit
Der Vorgang in Bahrain ist ein Extremfall, und niemand sollte seine Architektur allein auf Extremfälle auslegen. Aber er macht eine Annahme sichtbar, die im Normalbetrieb unsichtbar bleibt: dass die Plattform immer da ist.
Die Prüffrage lässt sich in einem Satz stellen und in einer halben Stunde beantworten. Wenn unsere primäre Region morgen dauerhaft ausfällt – welche Daten hätten wir noch, wo lagen sie, und wer hat den Wiederherstellungsweg schon einmal durchlaufen?
Mit kloudease liegt diese Aufgabe bei uns. Alles, was über kloudease auf deinem Cluster installiert ist, und jede Datenbank, die du als Managed Service über kloudease nutzt, ist komplett in Backup und Disaster Recovery enthalten – du musst dich darum nicht mehr kümmern. Wiederherstellungszeit, maximaler Datenverlust und Aufbewahrungsfristen sind im SLA festgelegt. Die Backups sind unveränderlich (immutable): Weder eine Fehlbedienung noch Ransomware kann sie nachträglich löschen oder überschreiben. Wir testen die Wiederherstellung, statt sie nur zu dokumentieren. Und für genau den Fall, um den es in diesem Beitrag geht, sichern wir optional zusätzlich in einen S3-kompatiblen Object Storage deiner Wahl, bei einem anderen Anbieter oder in deinem eigenen Rechenzentrum. Das ist die Kopie außerhalb, die die 3-2-1-Regel verlangt.
Offen bleibt nur, was außerhalb von kloudease liegt, etwa eine selbst betriebene Datenbank oder Daten in einem SaaS-Dienst. Dafür gelten die Punkte oben weiter, und wir sagen dir, wenn wir sehen, dass dort etwas fehlt.